LLM 同時有兩種知識來源:訓練時存進參數的記憶,以及推論時從提示或檢索拿到的情境。兩者不一致的時候,模型該信哪一個?這個問題叫知識衝突(knowledge conflict),RAG 普及之後變得很實際:檢索回來的文件可能過時、可能錯,也可能和模型記得的相反。
這篇把文獻分成幾塊:衝突的分類與資料、模型的實際行為、緩解方法、機制研究,最後是一些超出原本分類的新衝突類型。
分類與資料集 #
Xu 等人的綜述(arXiv 2403.08319)是常被引用的分類。它把知識衝突分成三類:
- context-memory:情境與參數記憶矛盾
- inter-context:不同情境之間矛盾
- intra-memory:模型記憶內部自己矛盾
每類都談成因、模型行為與解法,解法依介入時機分成 pre-hoc 與 post-hoc。綜述裡有幾個數字:GPT-4 在常識問答的自我一致性上仍有 13% 的不一致;BERT、RoBERTa、ALBERT 在知識一致性評估的準確率只在 50% 到 60%。它也指出現有解法的目標互相矛盾:「忠於情境」與「鑑別錯誤資訊、忠於記憶」是兩件相反的事。
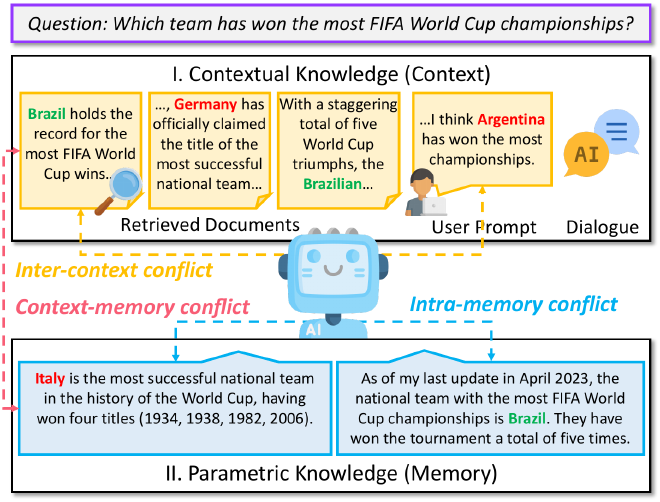
圖:以「哪一隊拿過最多次世界盃冠軍」為例,標出 inter-context、context-memory、intra-memory 三種衝突。取自 Xu 等,arXiv 2403.08319,依 CC BY-NC-ND 4.0 轉載,未修改(僅轉成圖檔、調整尺寸)。
資料集方面,最經典的是 NQ-Swap(Longpre 等,EMNLP 2021,arXiv 2109.05052):把支持段落裡的標準答案實體,換成同類型的干擾實體,讓情境和模型的閉卷答案乾淨地對立。ConflictBank(Su 等,NeurIPS 2024,arXiv 2408.12076)把這個做法放大,用實體替換和 LLM 生成的反事實,建出數百萬組主張與證據配對。DYNAMICQA(Marjanovic 等,2024)則改從事實本身的性質切入,分成靜態、時間性、可爭議三區,總共 11,378 組問答。
模型偏信記憶還是情境? #
這個問題的答案,早期文獻互相矛盾,後來的論文基本上都在處理這種矛盾。
Longpre 等人發現模型過度依賴參數記憶;之後有研究發現,當情境的證據多、而且可信時,模型反而偏向情境。Xie 等人(ICLR 2024)指出一個方法學問題:用實體替換構造的反記憶不連貫,可能導致「LLM 很固執」的錯誤結論。他們讓 ChatGPT 從零生成連貫的反記憶,再用 NLI 模型過濾。結果在 POPQA 上,ChatGPT 採用單一連貫反記憶的比例約 96%。不過多來源時模型又有確認偏誤,GPT-4 在最熱門的問題上,記憶化比率約 80%。順序也有影響:除 GPT-4 外,其他模型的波動超過 5%,PaLM2 和 Llama2-7B 甚至超過 30%。
Sun 等人(2025)換了角度,認為過去的研究幾乎只用情境問答,隱含「應該依賴情境」的假設。他們建立五類任務(知識自由、常識、參數知識、參數常識、RAG),為每個模型建個別化資料集,並把衝突分為無衝突(NC)、高可信衝突(HPC)、低可信衝突(LPC)三級。結果是行為取決於任務:GPT-5.2 在常識任務上 NC 與 LPC 的差距約 31 分;在參數知識任務上,NC 時 89.2,HPC 時掉到 33.7,LPC 時回升至 71.8。他們還發現,在 RAG 任務中,模型並沒有對可信度更高的段落展現更強的偏好。
DYNAMICQA 看的是事實的性質。它發現靜態事實最容易被情境改寫(Llama-2 的說服率 78.44%,時間性事實是 60.96%),而 Wikidata 的編輯次數比事實的流行度更能預測模型接不接受情境(邏輯迴歸 β = −0.08)。
緩解 I:解碼層 #
CAD(Shi 等,NAACL 2024,arXiv 2305.14739)的做法不用訓練:解碼時比較有情境和沒情境兩個輸出分布,把差異放大,公式是 softmax[(1+α)logit(y|c,x) − α·logit(y|x)]。LLaMA-30B 在 NQ-Swap 上從 9.6 升到 37.7;GPT-Neo 20B 在 MemoTrap 上從 37.1 升到 57.3。增益隨模型規模增加。代價是推論成本約 2 倍,α 需要調,而且 FLAN-T5 在無衝突的 NQ 上略降。
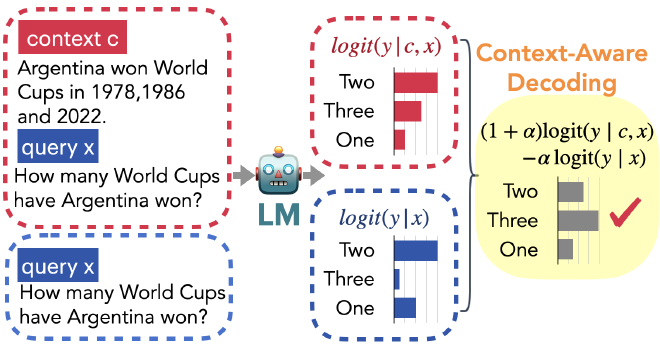
圖:CAD 的示意。有情境與無情境兩個輸出分布依 (1+α)logit(y|c,x) − α·logit(y|x) 結合,答案由「Two」翻成正確的「Three」。取自 Shi 等,arXiv 2305.14739,依 CC BY 4.0 轉載。
後續有 AdaCAD(Wang 等,arXiv 2409.07394,NAACL 2025):作者發現靜態的對比方法常常誤判衝突程度,在沒有衝突時反而過度調整,所以改成依每個實例,用情境分布與參數分布之間的 Jensen-Shannon 散度動態決定調整權重。CoCoA(Khandelwal 等,arXiv 2508.17670)是 token 層級的演算法,用 entropy gap、contextual peakedness 這類信心指標,加上兩個分布間的廣義散度來解決衝突,並強調在低衝突設定下表現不會變差,QA 準確率平均比 AdaCAD 高到 9.2 分。
緩解 II:神經元、表示與閘門 #
這幾篇是把介入位置往模型內部移。
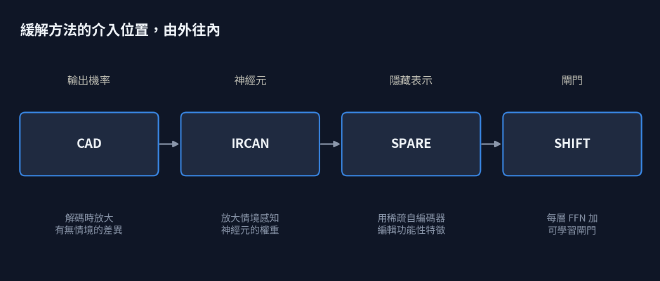
圖:CAD 到 SHIFT 的介入位置,由輸出往內。依本文的描述繪製。
- IRCAN(Shi 等,2024):用整合梯度算 FFN 神經元的「情境感知」歸因分數,挑出前 h 個神經元,把權重放大 β 倍。離線完成,沒有推論延遲,也能和 CAD 疊加。MemoTrap 上 LLaMA-2-7B 的準確率從 24.52% 升到 56.08%,CAD 是 44.56%,兩者疊加是 61.83%。強模型的增益有限,h 與 β 需要 grid search。
- SPARE(Zhao 等,arXiv 2410.15999,NAACL 2025 Oral):觀察到衝突訊號在中間層就能偵測。用預訓練稀疏自編碼器分解隱藏狀態,依互信息選出少數功能性特徵,推論時編輯激活,不需訓練。摘要稱超越表示工程方法 10%、對比解碼 15%。NQSwap、Llama3-8B 上,SPARE 在引導使用參數知識的 EM_M 是 47.51,CAD 是 33.72。它也指出,所有方法要引導模型改用參數知識都比較困難。
- SHIFT(Li 等,arXiv 2606.27786):在每層 FFN 加一個可學習的 sigmoid 閘門,backbone 凍結,可訓練參數少於 0.01%,用 GRPO 訓練。Qwen-3-0.6B 平均提升 6.16%,Qwen-3-8B 平均提升 2.64%,MMLU 平均下降不到 0.5%。
訓練與資料 #
- DisentQA(Neeman 等,2023):不強制偏向任何一邊,而是訓練單一 T5 模型同時輸出「情境答案」與「參數答案」。靠反事實資料擴增加上無答案擴增,反事實測試集上情境答案的準確率從 66.81% 升到 84.98%。限制是只適用於命名實體答案。
- KDS(Zhong 等,arXiv 2505.21958):從資料的角度看,指令微調資料和模型預訓練知識矛盾時會造成問題。對每題取樣 10 個回答,用 NLI 算「知識對齊」和「知識一致性」,再疊加品質與多樣性過濾。只用 1K 筆篩選資料的表現(48.77),就超過其他方法用 5K 筆的最佳結果(48.46)。論文以醫療指令微調為案例。
機制:衝突的知識存在哪裡? #
Jin 等人(arXiv 2402.18154)用資訊流的角度解釋衝突:後期層裡有作用相反的注意力頭,memory heads 負責從內部記憶回想知識,context heads 負責從外部情境擷取,而衝突出現的關鍵點,就是這兩股不一致的資訊流被整合的地方。他們據此提出 PH3,不更新參數,直接剪掉造成衝突的注意力頭。Pham 等人(arXiv 2601.09445)則研究 intra-memory 衝突,用合成傳記資料微調,再搭配 logit lens、activation patching 與跨模型激活修補(CMAP)定位。GPT-2 XL 中衝突知識主要在第 21 到 47 層,注意力元件的影響強於 MLP;CMAP 的引導成功率在 GPT-2 XL 最高 27%,在 Qwen3-4B 最高 70%。限制是只有 university 與 company 兩種衝突類型,只測兩個模型。
超出原本分類的新衝突 #
- 工具與記憶(Cheng 等,arXiv 2601.09760):定義 Tool-Memory Conflict,即參數知識與工具輸出矛盾。七個模型的平均衝突率 49.8%;70B 以上的模型衝突率在 26.9% 以下,小於 70B 的都在 48.6% 以上。RAG 能降低 2 到 15 個百分點,Vigilant Prompting 降 1 到 4 個,Opinion-based Prompting 幾乎沒效,作者的結論是這些方法都沒有從根本上解決。
- 文件之間(ConflictRAG,arXiv 2605.17301,投稿中):RAG 假設檢索到的文件彼此一致,實際常不成立。兩階段偵測(輕量分類器先篩,低信心再交給 LLM),成本降低 62%。限制是基線為作者自行實作,NQ-Conflict 資料是自建的。
- 情境順從的診斷(CDD,arXiv 2605.14473):RAG 只看最終準確率,分不出答案來自檢索證據、參數先驗,還是事後合理化。CDD 是五步驟提示:先抽取情境答案與參數答案,再檢查分歧、隔離衝突前提、解決。TruthfulQA 迷思注入上,標準 RAG 15.0%,CDD 62.0%。但它也做了因果介入:在 Gemini 上,注入錯誤的敏感度是 64.1%;三個 Claude 變體都在 −3% 到 +7% 之間,作者自己說這些模型上的增益不能歸因於軌跡真的在驅動答案。
- 實體歸屬錯誤(Deceptive Grounding,Caruzzo 等,arXiv 2607.09349):證據和參數知識並不矛盾,錯在證據被歸屬到錯誤的實體(把藥物 Y 的證據當成藥物 X 的)。13 個模型在受控基準下的峰值失效率是 8% 到 87%,其中醫療與生醫微調模型最高;但在 740 個藥物疾病配對的生產環境中,整體失效率是 7.8%。論文指出這落在現有知識衝突框架的盲點。
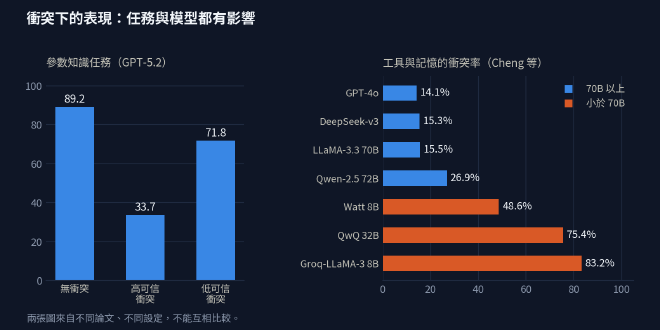
圖:左為 Sun 等人在參數知識任務上的結果(GPT-5.2),右為 Cheng 等人七個模型的工具與記憶衝突率。數字取自兩篇論文,設定不同,不能互相比較。
思考 #
- 早期的矛盾結論,多半來自設定的差異:Longpre 用實體替換,Xie 用連貫的反記憶,Sun 則指出任務本身會改變答案。三者可以同時成立。
- 規模的效應不是單調的。Cheng 的工具衝突率隨規模下降;Sun 看到前沿模型的落差仍達 31 分,在參數知識任務上甚至下降最陡;Xie 發現較大的模型在實體替換設定下更固執。各篇量的東西不同(衝突率、效能落差、記憶化比率),不能直接比。
- 緩解方法的介入層級一路往內走:輸出機率(CAD)、神經元(IRCAN)、隱藏表示(SPARE)、閘門(SHIFT)。但它們幾乎都在「讓模型更信情境」,SPARE 也坦承反方向更難。這和 Xu 綜述指出的目標衝突是同一件事:沒有一種方法判斷「該信哪邊」。
- 許多衝突資料是 LLM 生成的:Xie 的反記憶、Sun 的資料編輯、ConflictRAG 的 NQ-Conflict、CDD 的擾動,都是。Xu 綜述也提到現有分析大多依賴人工製造的衝突,這是共同的外部效度問題。
- Deceptive Grounding 的設定提醒了分類本身的邊界:當矛盾不存在,而是歸屬錯誤時,三分類框架看不到它。
- 報告的數字多半來自受控的最壞情境。Deceptive Grounding 的 87% 對生產環境的 7.8%,差了 5.5 倍。
參考文獻 #
- Xu 等,Knowledge Conflicts for LLMs: A Survey,arXiv 2403.08319
- Longpre 等,Entity-Based Knowledge Conflicts in Question Answering,EMNLP 2021,arXiv 2109.05052
- Su 等,ConflictBank: A Benchmark for Evaluating the Influence of Knowledge Conflicts in LLMs,NeurIPS 2024,arXiv 2408.12076
- Xie 等,Adaptive Chameleon or Stubborn Sloth: Revealing the Behavior of Large Language Models in Knowledge Conflicts,ICLR 2024,arXiv 2305.13300
- Sun、Bai、Dredze,Task Matters: Knowledge Requirements Shape LLM Responses to Context-Memory Conflict,arXiv 2506.06485
- Marjanovic 等,DYNAMICQA: Tracing Internal Knowledge Conflicts in Language Models,arXiv 2407.17023
- Shi 等,Trusting Your Evidence: Hallucinate Less with Context-aware Decoding,NAACL 2024,arXiv 2305.14739
- Wang 等,AdaCAD: Adaptively Decoding to Balance Conflicts between Contextual and Parametric Knowledge,NAACL 2025,arXiv 2409.07394
- Khandelwal 等,CoCoA: Confidence and Context-Aware Adaptive Decoding for Resolving Knowledge Conflicts in Large Language Models,arXiv 2508.17670
- Shi 等,IRCAN: Mitigating Knowledge Conflicts in LLM Generation via Identifying and Reweighting Context-Aware Neurons,arXiv 2406.18406
- Zhao 等,Steering Knowledge Selection Behaviours in LLMs via SAE-Based Representation Engineering(SPARE),NAACL 2025,arXiv 2410.15999
- Li 等,SHIFT: Gate-Modulated Activation Steering for Knowledge Conflict Mitigation in Retrieval-Augmented Generation,arXiv 2606.27786
- Neeman 等,DisentQA: Disentangling Parametric and Contextual Knowledge with Counterfactual Question Answering,arXiv 2211.05655
- Zhong 等,Resolving Knowledge Conflicts in Domain-specific Data Selection: A Case Study on Medical Instruction-tuning,arXiv 2505.21958
- Jin 等,Cutting Off the Head Ends the Conflict: A Mechanism for Interpreting and Mitigating Knowledge Conflicts in Language Models,arXiv 2402.18154
- Pham、Borkakoty、Hou,Where Knowledge Collides: A Mechanistic Study of Intra-Memory Knowledge Conflict in Language Models,arXiv 2601.09445
- Cheng、Pan、Amiri,Investigating Tool-Memory Conflicts in Tool-Augmented LLMs,arXiv 2601.09760
- Wang 等,ConflictRAG: Detecting and Resolving Knowledge Conflicts in Retrieval-Augmented Generation,arXiv 2605.17301
- Chen 等,Does RAG Know When Retrieval Is Wrong? Diagnosing Context Compliance under Knowledge Conflict(CDD),arXiv 2605.14473
- Caruzzo、Yoo、Kim,Deceptive Grounding: Entity Attribution Failure in Clinical Retrieval-Augmented Generation,arXiv 2607.09349