長文本的事實查核有個難處:一段文字裡常常同時有對的和錯的資訊,整段給一個真假分數太粗。現在最常見的做法是分解式(decompose-then-verify):先把文字拆成一條條原子主張,再逐條對照證據驗證,最後把結果聚合起來。
這篇把相關論文依它們處理的問題分組:基本流程、分解有沒有幫助、要拆多細、拆得好不好怎麼評,以及延伸到專門領域的工作。
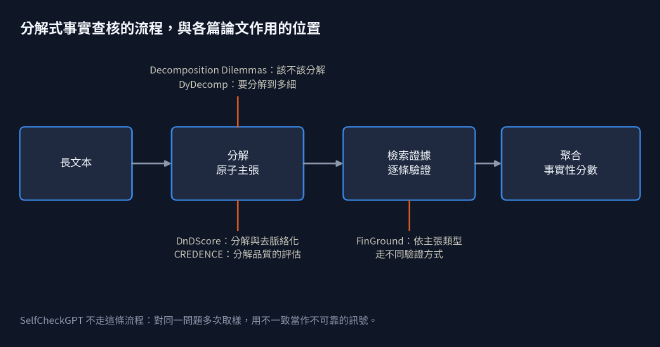
圖:流程與各篇論文作用的位置。依本文的分組繪製。
基本流程 #
FActScore(Min 等,EMNLP 2023,arXiv 2305.14251)確立了這個做法:把長文拆成原子事實,逐條對外部知識來源(Wikipedia)驗證,計算被支持的比例。之後的 FacTool、VeriScore 也沿用先分解再驗證的結構。
另一種完全不同的思路是 SelfCheckGPT(Manakul 等,EMNLP 2023,arXiv 2303.08896):不需要任何外部參照,對同一個問題取樣多次生成,把跨樣本的不一致視為模型不可靠的證據。它不拆主張,也不查證據,偵測的是「不穩定」。
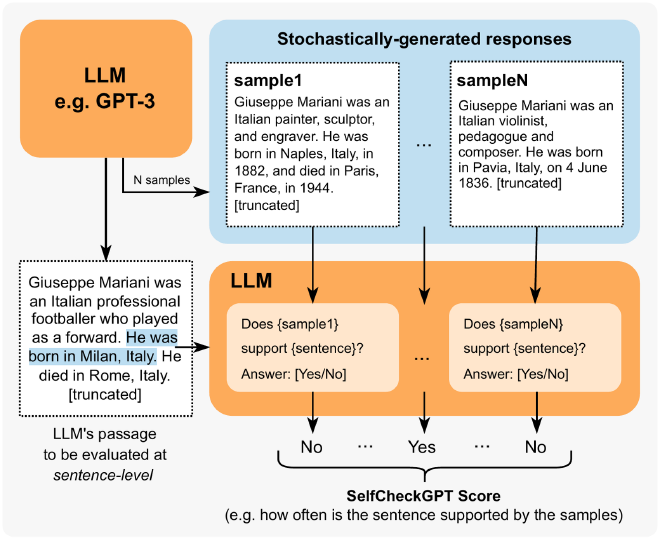
圖:SelfCheckGPT 把待評估的句子,逐一和多次隨機生成的回答比對,把「是否被支持」的結果彙整成分數,不需要外部資料庫。取自 Manakul 等,arXiv 2303.08896,依 CC BY 4.0 轉載。
拆了就比較準嗎? #
Decomposition Dilemmas(Hu、Long、Wang,南洋理工大學,arXiv 2411.02400)針對一個矛盾:過去的報告對分解的效益說法不一,有的說有益,有的在相同資料集、不同驗證模型下沒有一致效益,有的發現 ChatGPT 受益、GPT-4 反而下降。
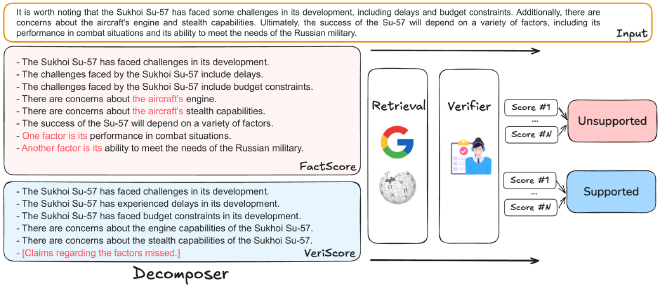
圖:同一段輸入,FactScore 與 VeriScore 拆出不同的子主張(紅字為問題處:FactScore 的子主張指代不明,VeriScore 漏掉了關於「成功取決於哪些因素」的主張),再經過檢索、驗證與聚合。取自 Hu 等,arXiv 2411.02400,依 CC BY-NC-SA 4.0 轉載(僅調整尺寸)。圖中的 Google 與維基百科標誌屬於各自的權利人。
- 方法:統一的四階段管線(分解、檢索、驗證、聚合),在 WICE、CLAIMDECOMP、FELM、BINGCHAT 四個資料集上,交叉比較分解器(VeriScore、FactScore、Wice、不分解)與驗證器(AlignScore、Minicheck、GPT-4o-mini)。分解錯誤歸成四類:上下文資訊遺漏、歧義、過度分解、原意改變。
- 結果:WICE 上用 Minicheck,所有分解都讓效能下降,最大降幅約 9 個百分點(FactScore 分解 BAcc 71.11,基線 80.01)。FELM 上 Minicheck 搭配 VeriScore,F1 從 48.10 升到 67.56。FELM 上 GPT-4o-mini 搭配 FactScore(平均 8.69 個子主張),BAcc 降到 57.86,F1 從 71.56 掉到 54.34。
- 規律:輸入越複雜,分解越有幫助。拉長輸入的 WICElong 上,Minicheck 的分解由負轉正(56.53 對 55.52);輸入複雜度為 1 時,所有分解都降低 F1。子主張數不超過輸入句數時,效益維持正向。
- 補救:加入「錯誤反思」(先偵測分解錯誤再回饋),BINGCHAT 上 FactScore 的 F1 從 24.91 升到 67.70。GPT-4o 偵測分解錯誤,與人工的一致率是 83%。
- 限制:只做二元標籤;檢索噪音與分解噪音沒有分別量化;複雜度只用長度與句數代理。
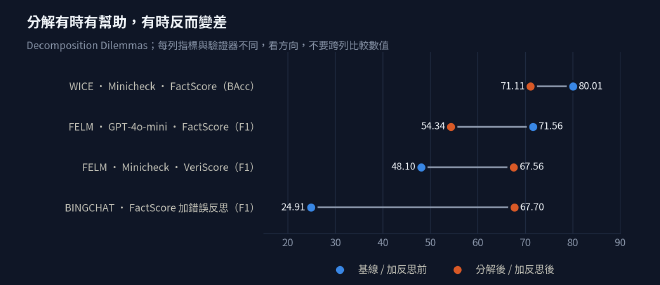
圖:Decomposition Dilemmas 的四個設定,分解前(藍)與分解後(橘)。每列的指標與驗證器不同,只看方向。
要拆多細? #
Optimizing Decomposition for Optimal Claim Verification(Lu、Ziems、Dang、Jiang,Notre Dame,arXiv 2503.15354)把問題說成:分解策略多半是手寫示範,跟下游驗證器在「原子性」上沒有對齊。
- 方法:形式化成雙層最佳化,提出 DyDecomp。用 MDP 加 PPO 訓練一個 4.73M 參數的小策略,LLM 本身凍結,動作是「分解」或「不分解」,獎勵是驗證器置信度的變化。
- 結果:摘要說,在不同驗證器、資料集、原子性上平均,置信度提升 0.07、準確率提升 0.12(0 到 1 量表);但論文的主要結果把 0.12 的準確率提升限定在 PerplexityAI 資料集、原子性 1 與 2,兩處措辭略有出入。不同驗證器的最佳原子性不同:Llama3-Inst-8B 搭配檢索約在 0,FT-T5-3B 搭配檢索約在 2。置信度與準確率的 Pearson r 是 0.88。
- 限制:驗證器能力不足時,置信度提升轉不成準確率提升;只優化原子性;用置信度當獎勵有過度優化的跡象;只用傳記領域。
拆得好不好,怎麼評? #
DnDScore(Wanner、Van Durme、Dredze,arXiv 2412.13175,EMNLP 2025)指出分解和去脈絡化目的相反:前者要把資訊切乾淨,後者要把資訊補回去,兩者組合的順序會影響結果。FActScore 設定下,只分解是 33.00%,先分解再去脈絡化是 45.97%。這約 13 個百分點的提升,有一部分來自補進去的上下文,不是純粹的原子事實驗證;去重後分數下降近 4%。
CREDENCE(Tran、Mai、Le,arXiv 2606.19819,預印本)則針對評估指標:用 Jaccard(詞彙重疊)評估分解,會低估同義改寫與代詞還原的品質。它提出 Entity Preservation Rate 與 Semantic-F1,Semantic-F1 平均比 Jaccard-F1 高約 25 個百分點。下游事實查核準確率:SciFact 從 0.541 升到 0.799,LIAR-PLUS 從 0.511 升到 0.670,FEVER 只從 0.898 到 0.900。限制:人工偏好研究只有 82 組,p = 0.2206,不顯著;LLM 自我修復約有 4% 會退化;參考分解由規則生成,絕對分數只是下界。
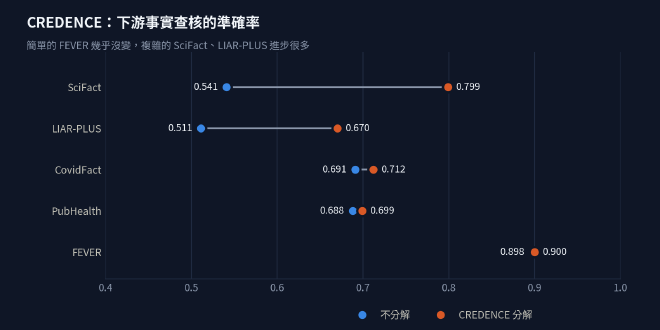
圖:五個資料集上,不分解與 CREDENCE 分解的下游準確率。
延伸到專門領域 #
FinGround(Guo、Wu、Yiu,香港大學,arXiv 2604.23588)把分解用在金融文件。拆完主張後依類型分成六類(數值、時間、實體屬性、比較、法規、計算),不同類型走不同驗證。計算型主張用 47 個公式模板重算,容差 ±0.5%,F1 達 90.2,比 SelfCheckGPT 高 18.9。六類比三類高 4.3 F1,十類沒有顯著增益(p = 0.23)。每次查詢成本約 0.003 美元,GPT-4o 為 0.047 美元。限制:僅英語與美國 SEC 文件;資料集由 GPT 系列生成,又用 GPT-4o 當教師標注,有循環依賴;±5% 邊界附近的數值錯誤召回只有 71.4%。
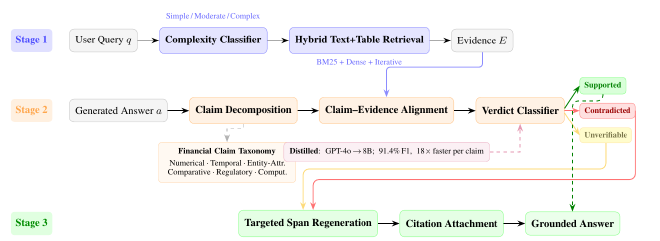
圖:FinGround 的流程。第一階段檢索文字與表格證據;第二階段把答案拆成原子金融主張並判定;第三階段重寫被反駁或無法驗證的主張並附上引用。取自 Guo 等,arXiv 2604.23588,依 CC BY 4.0 轉載(擷取自論文頁面,僅含圖本身)。
DeepHalluBench(Zhan 等,浙江大學與香港大學,arXiv 2601.22984)把原子分解搬到 deep research agent 的整條軌跡上:查詢拆成子查詢,計畫拆成動作,摘要拆成聲明。100 個查詢、六個系統;整體幻覺分數 H 最低的是 OpenAI(0.1546),最高的是 Perplexity(0.2084)。Grok 因網頁介面不暴露規劃軌跡,部分欄位空白。
思考 #
- 「分解有沒有幫助」取決於驗證器強度與輸入複雜度。Decomposition Dilemmas 在強驗證器加簡單輸入時看到負效益;CREDENCE 在複雜的科學與政治主張上進步很大,在簡單的 FEVER 上幾乎為零。兩者方向一致,不過 CREDENCE 比的是「不分解」對「自己的分解」,驗證器也不同,不是同一條件的對比。
- 粒度比較像要跟驗證器配對的超參數。DyDecomp 顯示不同驗證器的最佳原子性不同,FinGround 則顯示分類粒度有甜蜜點(六類優於三類,十類沒有再增益)。
- 錯誤反思與自我修復的結論看似相反:前者大幅提升 F1,後者實測約 4% 退化。差別在設定:Decomposition Dilemmas 由 GPT-4o 先偵測錯誤再回饋,CREDENCE 的自我修復沒有外部回饋。這是依兩篇設定做的對照,兩篇都沒有這樣明說。
- 不同論文的事實性分數不能直接比。DnDScore 顯示,單是分解與去脈絡化的配置,就能讓同一個分數差十幾個百分點。
- 通用的 FActScore 式分解在專門場景下不夠:金融需要分辨哪些是算出來的,agent 要拆的是一整串行動,而不只是文字。
- SelfCheckGPT 偵測的是跨取樣的不一致,分解式方法查的是與證據的一致;兩者針對的是不同類型的錯誤。
參考文獻 #
- Min 等,FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation,EMNLP 2023,arXiv 2305.14251
- Manakul 等,SelfCheckGPT: Zero-Resource Black-Box Hallucination Detection for Generative Large Language Models,EMNLP 2023,arXiv 2303.08896
- Hu、Long、Wang,Decomposition Dilemmas: Does Claim Decomposition Boost or Burden Fact-Checking Performance?,arXiv 2411.02400
- Lu、Ziems、Dang、Jiang,Optimizing Decomposition for Optimal Claim Verification,arXiv 2503.15354
- Wanner、Van Durme、Dredze,DnDScore: Decontextualization and Decomposition for Factuality Verification in Long-Form Text Generation,EMNLP 2025,arXiv 2412.13175
- Tran、Mai、Le,CREDENCE: Claim Reduction for Decomposition & Enhanced Credibility,arXiv 2606.19819
- Guo、Wu、Yiu,FinGround: Detecting and Grounding Financial Hallucinations via Atomic Claim Verification,2026
- Zhan 等,Why Your Deep Research Agent Fails? On Hallucination Evaluation in Full Research Trajectory(DeepHalluBench),2026