傳統的目標偵測器只認得訓練資料裡標過的類別。要多認一種東西,就得補標註、重新訓練。開放詞彙目標偵測(open-vocabulary object detection,OVOD)想解決的就是這件事:讓偵測器用文字描述去找沒有框標註過的類別。
這篇不依時間排,而是照「CLIP 的圖文知識怎麼進到偵測器裡」把論文分成幾條路線,最後看一條新的線:詞彙由 LLM 來決定。
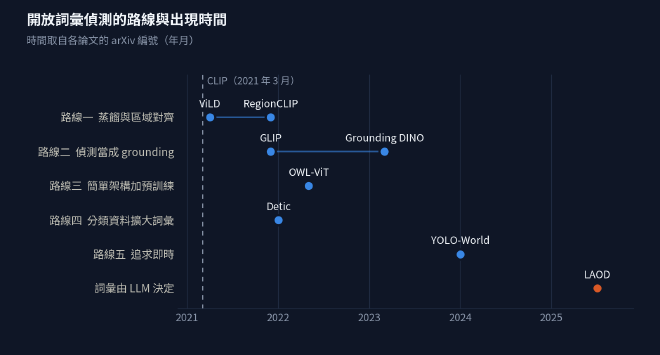
圖:各路線的代表論文,時間取自 arXiv 編號。依本文的分組繪製。
為什麼需要? #
兩個問題一起造成了這個方向。CLIP(Radford 等,ICML 2021)的摘要開頭就說,現有的視覺系統被訓練去預測一組固定的類別,要指定任何其他視覺概念都需要額外標註資料。Detic(Zhou 等,ECCV 2022)則從偵測資料的角度說:偵測資料集規模小,所以偵測器的詞彙量也小;分類資料集大得多,詞彙也大得多。
起點:CLIP #
CLIP 在 4 億組圖文配對上訓練「哪段文字配哪張圖」這個任務。訓練完之後,用自然語言就能指涉學到的視覺概念,零樣本遷移到下游任務。摘要提到在 ImageNet 上不用 128 萬張訓練樣本,就達到原始 ResNet-50 的準確率。
後面幾乎所有 OVOD 都在想同一件事:怎麼把這個「整張圖對整段文字」的能力,變成「某個區域對某個詞」。
路線一:蒸餾與區域對齊 #
ViLD(Gu 等,ICLR 2022)把預訓練視覺語言分類器當老師,把知識蒸餾到兩階段偵測器:老師編碼類別文字和影像區域,學生偵測器讓自己的區域嵌入去對齊。LVIS 把稀有類別留作未見類別,ResNet-50 版本達到 16.1 mask AP_r,比有監督版本還高 3.8;換成更強的 ALIGN 老師是 26.3 AP_r。不調整直接轉移到 COCO 是 36.6 AP。
RegionCLIP(Zhong 等,arXiv 2112.09106)先指出一個問題:直接把 CLIP 拿去辨識影像區域,效果很差,因為 CLIP 學的是整張圖對整段描述,沒有區域與文字片段的細粒度對齊。它用 CLIP 把區域和模板描述配對,再預訓練模型對齊這些區域與文字配對。轉移到 OVOD 之後,對 COCO 的新類別比當時最佳高 3.8 AP50,對 LVIS 的新類別高 2.2 AP。
路線二:把偵測當成 grounding #
GLIP(Li 等,CVPR 2022)把物件偵測和 phrase grounding 統一成同一個預訓練任務。好處有兩個:能同時從偵測資料和 grounding 資料學習,也能用自訓練的方式替海量圖文配對生成 grounding 框。預訓練資料是 2,700 萬筆 grounding 資料,其中 300 萬人工標註、2,400 萬網路爬取。直接評估在 COCO 和 LVIS 上(預訓練沒看過 COCO 的圖),分別是 49.8 AP 和 26.9 AP;在 COCO 上微調後達到 60.8 AP(val)。
Grounding DINO(Liu 等,ECCV 2024)把 Transformer 偵測器 DINO 和 grounded pre-training 結合,可以用類別名稱或指稱語句偵測任意物件。它把封閉集偵測器拆成三個階段,各自做跨模態融合:feature enhancer、language-guided query selection 和 cross-modality decoder。COCO 零樣本遷移是 52.5 AP,ODinW 零樣本平均是 26.1 AP。它還額外在指稱語句理解(RefCOCO/+/g)上評估,檢驗用屬性描述物件的能力。
路線三:簡單架構,加上大規模預訓練 #
OWL-ViT(Minderer 等,ECCV 2022)刻意走簡單:標準的 Vision Transformer,幾乎不改動,先做對比式圖文預訓練,再做端到端的偵測微調。他們分析規模特性,結論是增加影像層級的預訓練量和模型大小,下游偵測表現會持續提升。同一套設定也支援文字條件的零樣本偵測,以及用範例圖當條件的單樣本偵測。
路線四:把詞彙擴大到分類資料 #
Detic(Zhou 等,ECCV 2022)的思路是直接拿影像分類資料來訓練偵測器的分類器,不需要複雜的方式去把影像標籤指派給框,所以可以套在各種偵測架構上。開放詞彙 LVIS 上,所有類別提升 2.4 mAP,新類別提升 8.3 mAP。他們也第一次用 ImageNet 全部 21,000 個類別訓練偵測器,並展示它不用微調就能泛化到新資料集。
路線五:追求即時 #
YOLO-World(Cheng 等,CVPR 2024)觀察到 YOLO 系列雖然高效,但依賴預先定義好的類別。它在 YOLO 上加入開放詞彙能力,提出 RepVL-PAN(可重參數化的視覺語言路徑聚合網路)和區域文字對比損失,讓視覺與語言資訊互動。LVIS 上 35.4 AP,在 V100 上 52.0 FPS,它的主打是同時兼顧準確度與速度。
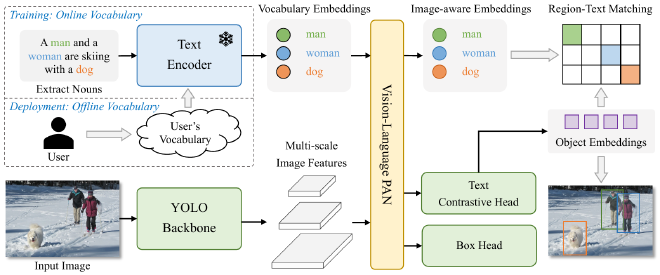
圖:YOLO-World 的整體架構。文字編碼器產生詞彙嵌入,經 RepVL-PAN 與影像特徵融合,最後做區域與文字的匹配。取自 Cheng 等,arXiv 2401.17270,依 CC BY-NC-SA 4.0 轉載(僅調整尺寸)。
新的一條線:詞彙從哪來? #
上面幾條路線有個共同前提:類別名稱是使用者給的。LAOD(Mumcu 等,arXiv 2507.10844)針對這點出發:OWOD 對未知物件沒有語意標籤,OVOD 又依賴使用者提示,限制了自主性。它的做法是提示 LLM 針對場景自己產生物件名稱,再把這些名稱交給 OVOD 去定位,達到完全不需要標籤的零樣本偵測。實驗在 LVIS、COCO、COCO-OOD 上做。
因為名稱是模型自己產生的,LAOD 提出兩個指標分開評:CAAP(Class-Agnostic AP)只看定位,SNAP(Semantic Naming AP)只看命名。
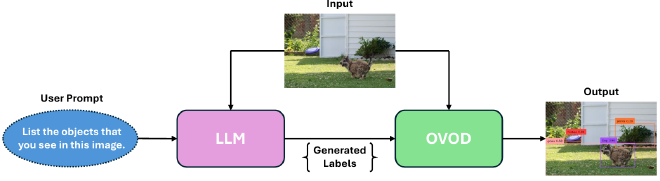
圖:LAOD 的整體架構,由輸入圖片與提示詞經 LLM 產生標籤,再交給開放詞彙偵測器定位。取自 Mumcu 等,arXiv 2507.10844,依 CC BY-NC-ND 4.0 轉載,未修改(僅調整尺寸)。
用到的 LLM 一端,論文引用了 Gemma 3 與 Qwen2.5-VL 兩份技術報告。Gemma 3 是輕量開放模型家族的多模態版本,規模從 10 億到 270 億參數,上下文至少 128K。Qwen2.5-VL 的摘要特別強調,它能用邊界框或點來精確定位物件。
評測基準 #
這一整條線大多用 COCO(Lin 等,ECCV 2014)和 LVIS。ViLD 把 LVIS 的稀有類別留作未見類別,用 AP_r 評估;GLIP 在 COCO 與 LVIS 上看零樣本 AP。COCO 的偵測任務是 80 個類別。
思考 #
以下是讀完這批論文後,從論文內容能推出的幾點。
- 各條路線的差別,在於 CLIP 的圖文知識用什麼方式進到偵測器:蒸餾(ViLD)、區域層級預訓練(RegionCLIP)、grounding 資料(GLIP、Grounding DINO)、直接微調 ViT(OWL-ViT)、分類資料(Detic)。
- 數字很難互相比較。ViLD 報的是 LVIS 稀有類別的 mask AP_r,GLIP 是零樣本的 AP,Detic 是開放詞彙 LVIS 的 mAP,各自的資料切分和指標不一樣。
- 當詞彙由模型而非使用者給定,評測要同時回答兩個問題:框準不準,名字對不對。LAOD 把它們拆成兩個指標,正是這個原因。
- Qwen2.5-VL 自己就能輸出框或點,這讓「LLM 負責說出有什麼、偵測器負責框位置」的分工界線,比前幾條路線更模糊。
- COCO 只有 80 個類別。開放詞彙模型若說出標註之外的真實物件,在這種封閉標註下無法被算成正確;這是把開放詞彙模型放在封閉類別基準上評分時,結構上就存在的問題。
參考文獻 #
- Radford 等,Learning Transferable Visual Models From Natural Language Supervision,ICML 2021,arXiv 2103.00020
- Gu 等,Open-vocabulary Object Detection via Vision and Language Knowledge Distillation(ViLD),ICLR 2022,arXiv 2104.13921
- Zhong 等,RegionCLIP: Region-based Language-Image Pretraining,arXiv 2112.09106
- Li 等,Grounded Language-Image Pre-training(GLIP),CVPR 2022,arXiv 2112.03857
- Minderer 等,Simple Open-Vocabulary Object Detection with Vision Transformers(OWL-ViT),ECCV 2022,arXiv 2205.06230
- Zhou 等,Detecting Twenty-thousand Classes using Image-level Supervision(Detic),ECCV 2022,arXiv 2201.02605
- Liu 等,Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection,ECCV 2024,arXiv 2303.05499
- Cheng 等,YOLO-World: Real-Time Open-Vocabulary Object Detection,CVPR 2024,arXiv 2401.17270
- Mumcu 等,LLM-Guided Agentic Object Detection for Open-World Understanding(LAOD),arXiv 2507.10844
- Gemma Team,Gemma 3 Technical Report,arXiv 2503.19786
- Qwen Team,Qwen2.5-VL Technical Report,arXiv 2502.13923
- Lin 等,Microsoft COCO: Common Objects in Context,ECCV 2014