「世界模型」在強化學習裡指環境的預測模型,在影片生成裡指能模擬場景的生成器,在機器人學裡又是另一種意思。2026 年 7 月 7 日到 8 月 6 日之間,用文獻搜尋工具找到約 60 篇相關論文,其中 9 篇做了較完整的閱讀。這篇照它們各自處理的問題分組。
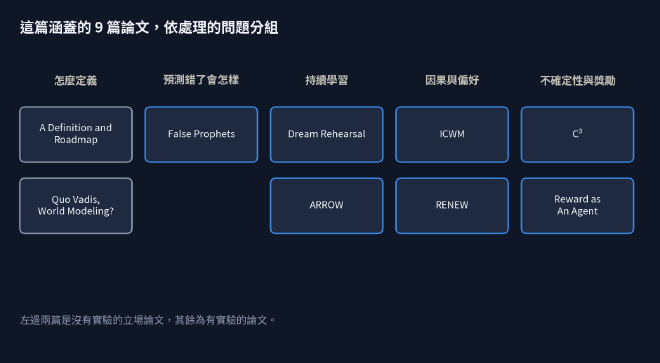
圖:本文涵蓋的 9 篇論文與分組。依本文的分組繪製。
這些都是 2026 年 6 到 8 月的 arXiv 預印本,是否通過審查沒有確認,所以只標 arXiv 編號。
世界模型要怎麼定義? #
兩篇立場論文,都沒有實驗,但切入的軸不同。
A Definition and Roadmap for World Models(arXiv 2607.06401) #
- 問題:world model 一詞在不同子領域被各自挪用,缺乏共通定義。
- 定義:在有限計算資源約束下,對物理世界狀態轉移過程的壓縮建模。
- 分類:依「怎麼表徵與傳播世界狀態」分三類。Observation-Level Generative(Sora、Wan、Genie、Cosmos),Latent-Space Models(Dreamer、JEPA 系列),3D-Enhanced / Object-Centric。
- 另一個區分:只預測觀測的 action-free 預測,學到的是「觀測動態」;以行動為條件的預測,才逼近「介入動態」。
- 路線圖:統一多模態、統一物理表徵、基礎規模的互動模擬器。
Quo Vadis, World Modeling?(arXiv 2608.02713) #
- 問題:持續改進的 agent 需要互動回饋,但真實環境又慢、又貴、又不安全,也難以平行。傳統只預測物理狀態的世界模型範疇太窄。
- 提出 Agent-Centric Interactive World Proxy,把物理狀態轉移推廣為 agent 可用的資訊轉移。
- 六種功能形式:dynamics、spatial、execution、memory/experience、skill、reward/verification。三個賦能層級:推理時引導、訓練時優化、agent 與 proxy 共同演化。
- 評價標準:從世界模型自己多強,轉向它讓 agent 變得多好。
- 四個開放挑戰:擬真度與想像力的極限、何時該信任代理、獎勵駭客與安全性、以資訊增益為準的評測。
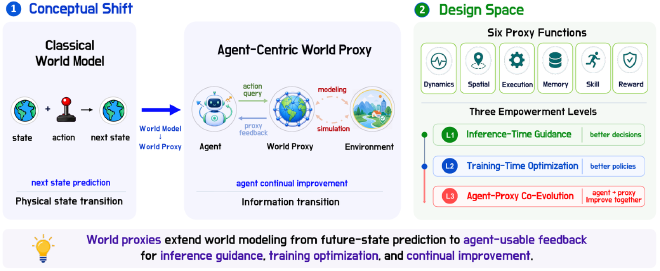
圖:左為從「預測物理狀態轉移」的傳統世界模型,轉向「預測資訊轉移」的 agent-centric world proxy;右為六種功能與三個賦能層級。取自 Yu 等,arXiv 2608.02713,依 CC BY-SA 4.0 轉載(僅調整尺寸)。
世界模型預測錯了會怎樣? #
False Prophets(arXiv 2607.23147) #
- 問題:agent 用文字型世界模型(如 Qwen-AgentWorld、Meta Code World Model)預測動作的結果。預測錯誤本身就是新的攻擊面,而這類模型的安全性還沒被研究過。
- 方法:套用 CIA 三元組,歸納七種攻擊向量,建立 AgentWorld-Robust benchmark(700 個腳本,每類 100 個)。四類是世界建模固有的(可計算性、非確定性、缺失知識、外部環境),三類是技術性、可修復的(token 計數、誤導性模式、提示注入)。
- 結果:攻擊者可誘導錯誤預測,成功率最高 95%。Qwen-AgentWorld 35B 與 CWM 32B 預測 exit code 的準確率是 86% 與 77%,預測實際輸出只剩 44% 與 23%。95% 的樣本被低估執行時間,21% 的樣本一小時內跑不完,模型卻預測不到一秒。兩個模型都偏樂觀。誤導性模式與提示注入的準確率反而是最高的。
- 限制:只測兩個公開模型;benchmark 由 LLM 生成。
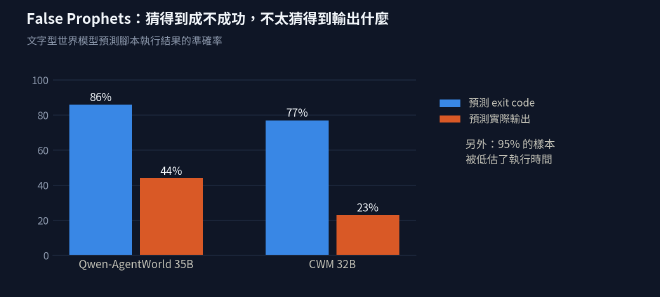
圖:兩個文字型世界模型預測 exit code 與預測實際輸出的準確率。數字取自論文摘要整理。
持續學習:記憶在哪一層? #
The World Model Remembers, the Actor Forgets(arXiv 2607.19749) #
- 問題:DreamerV3 家族在任務序列上災難性遺忘,即使保留無限 replay buffer 也一樣。
- 方法:先做元件層級的探測與凍結干預,發現世界模型保留了舊任務的知識,崩潰的是 actor。提出 Dream Rehearsal:用世界模型自己想像並評分的軌跡,對 actor 做監督式自我模仿,不需任務標籤,參數也不增長。
- 結果:凍結世界模型後,在想像中做 RL 只恢復 0/3 個種子,監督式夢境自我模仿恢復 3/3。4 任務鏈上普通 replay 是 0/3,Dream Rehearsal 是 3/3;8 任務鏈 3 個種子全數通過。對照「模仿真實片段」,配對差異 +0.131(bootstrap 95% CI 0.073 到 0.238)。
- 限制:只在 MiniGrid 與 17M 參數的規模驗證,更大規模作者列為開放問題。論文附預先註冊的協議。
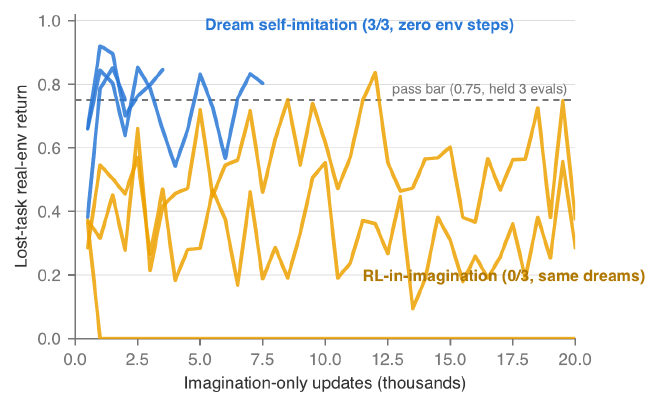
圖:凍結同一個世界模型、使用相同的想像資料時,被遺忘任務的真實環境回報。藍色是監督式夢境自我模仿,3 個種子都在 2,000 到 7,500 次更新內超過 0.75 的及格線;橘色是在想像中做 RL,更新 20,000 次後 0 個種子通過,其中一個種子掉到零。取自 Nijjer,arXiv 2607.19749,依 CC BY 4.0 轉載。
ARROW(arXiv 2603.11395) #
用雙緩衝(短期加以分佈匹配抽樣的長期)取代 FIFO,把重播餵給世界模型而不是策略,在持續學習設定下減少遺忘。受 Complementary Learning Systems 啟發,延伸自 DreamerV3。
因果與偏好 #
ICWM(arXiv 2607.26336) #
- 問題:多智能體環境中,世界模型常把統計相關誤當因果;物理與其他 agent 的意圖交織,分佈偏移下失效。
- 方法:把他人意圖視為結構因果模型的混淆變數,用「隨機軟性介入」取代硬性介入。
- 結果:介入強度越高,圖誤差與分佈外誤差越低(1,240 個訓練模型彙整)。介入強度是主要槓桿,恢復的因果圖只是副產品。環境全是模擬。
RENEW(arXiv 2607.14180) #
- 問題:離線 RL 中,策略會利用世界模型在資料稀疏區域的漏洞。
- 方法:DLHF 用偏好直接監督動態模型,偏好須編碼「物理真實性」而非任務成功度;RENEW 再用認知不確定性挑選要問的偏好。
- 結果:Sliding Tile 3×3,100K 標籤後的驗證誤差,預訓練 1.3200,naive 0.4190,RENEW 0.2070。偏好標籤由合成 oracle 產生,不是真人標註。
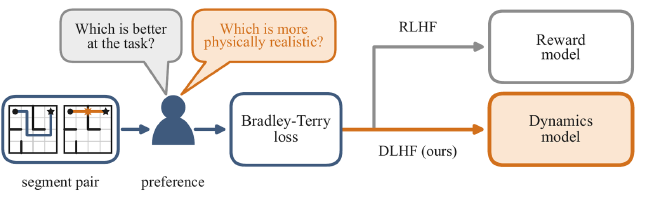
圖:RLHF 與 DLHF 共用同一套偏好機制,但監督的元件不同。RLHF 用偏好訓練獎勵模型,標籤反映任務成功;DLHF 讓同樣的標籤直接監督動態模型,標籤反映物理真實性。取自 Bhamidipaty 等,arXiv 2607.14180,依 CC BY 4.0 轉載(僅調整尺寸)。
不確定性與獎勵 #
- C³(arXiv 2512.05927):替影片世界模型輸出像素層級的信心熱力圖,校準保證只在訓練分佈內嚴格成立。
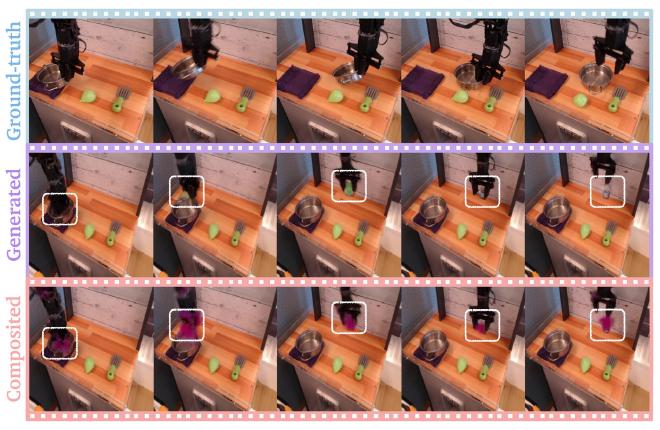
圖:機器人夾取鍋子的影片。第一列是真實畫面,第二列是模型生成的畫面,白框處出現了違反物理的綠色物體並持續變形;第三列疊上 C³ 的不確定性(洋紅色),標出模型對這些幻覺高度不確定。取自 Mei 等,arXiv 2512.05927,依 CC BY 4.0 轉載(僅調整尺寸)。畫面為機器人操作資料集的實拍影片。
- Reward as An Agent(arXiv 2606.19990):用 agentic 驗證提供穩健獎勵,搭配動態感知的 rollout 多樣化,緩解 reward hacking。
ARROW、C³ 與 Reward as An Agent 這三篇,這裡只列定性描述,沒有放具體數字。
思考 #
- 兩篇立場論文用的是兩套不同的軸,一個問「用什麼表徵」,一個問「拿來做什麼」,兩套分類沒有對應起來。可見這個領域還在自己定義自己。
- Quo Vadis 的第三個挑戰是獎勵駭客與安全性,False Prophets 提供了實證;Reward as An Agent 則從獎勵端提出對策。
- Dream Rehearsal 的核心發現是,遺忘發生在「讀出」的 actor,而不是世界模型的記憶。RENEW 同樣偏向用監督式訊號(偏好)直接修世界模型,而不是靠策略梯度。
- 持續學習這條線上,ARROW 處理世界模型該吃什麼資料,Dream Rehearsal 處理 actor 怎麼讀出,兩者處理的是不同環節。
- 有實驗的幾篇都在小規模或模擬環境:MiniGrid、合成偏好標籤、程式化多智能體環境。
- False Prophets 的結果有個反直覺之處:預測「會不會成功」(exit code)的準確率遠高於預測「輸出什麼」,而且誤導性模式與提示注入的準確率反而是最高的一類。
參考文獻 #
- A Definition and Roadmap for World Models,arXiv 2607.06401
- Quo Vadis, World Modeling?,arXiv 2608.02713
- False Prophets: On the Security of World Models in Agentic Systems,arXiv 2607.23147
- The World Model Remembers, the Actor Forgets: Dream Rehearsal for Continual Model-Based RL,arXiv 2607.19749
- ARROW: Augmented Replay for RObust World models,arXiv 2603.11395
- Learning Implicit Causal World Models from Multi-Agent Demonstrations,arXiv 2607.26336
- RENEW: Towards Learning World Models and Repairing Model Exploitation from Preferences,arXiv 2607.14180
- World Models That Know When They Don’t Know: Controllable Video Generation with Calibrated Uncertainty(C³),arXiv 2512.05927
- Reward as An Agent for Embodied World Models,arXiv 2606.19990